La plupart des écrits techniques n'abordent qu'une seule étape — la normalisation, l'appel au LLM, l'algorithme de correspondance. Mais les utilisateurs ne vivent pas des étapes. Ils vivent un flux : déposer un fichier, patienter un instant, revoir le résultat, envoyer le devis. Parcourons l'import assisté par IA du point de vue de l'utilisateur, y compris les détails qui font la différence entre un outil qui semble intelligent et un outil qui semble être une simple démonstration.
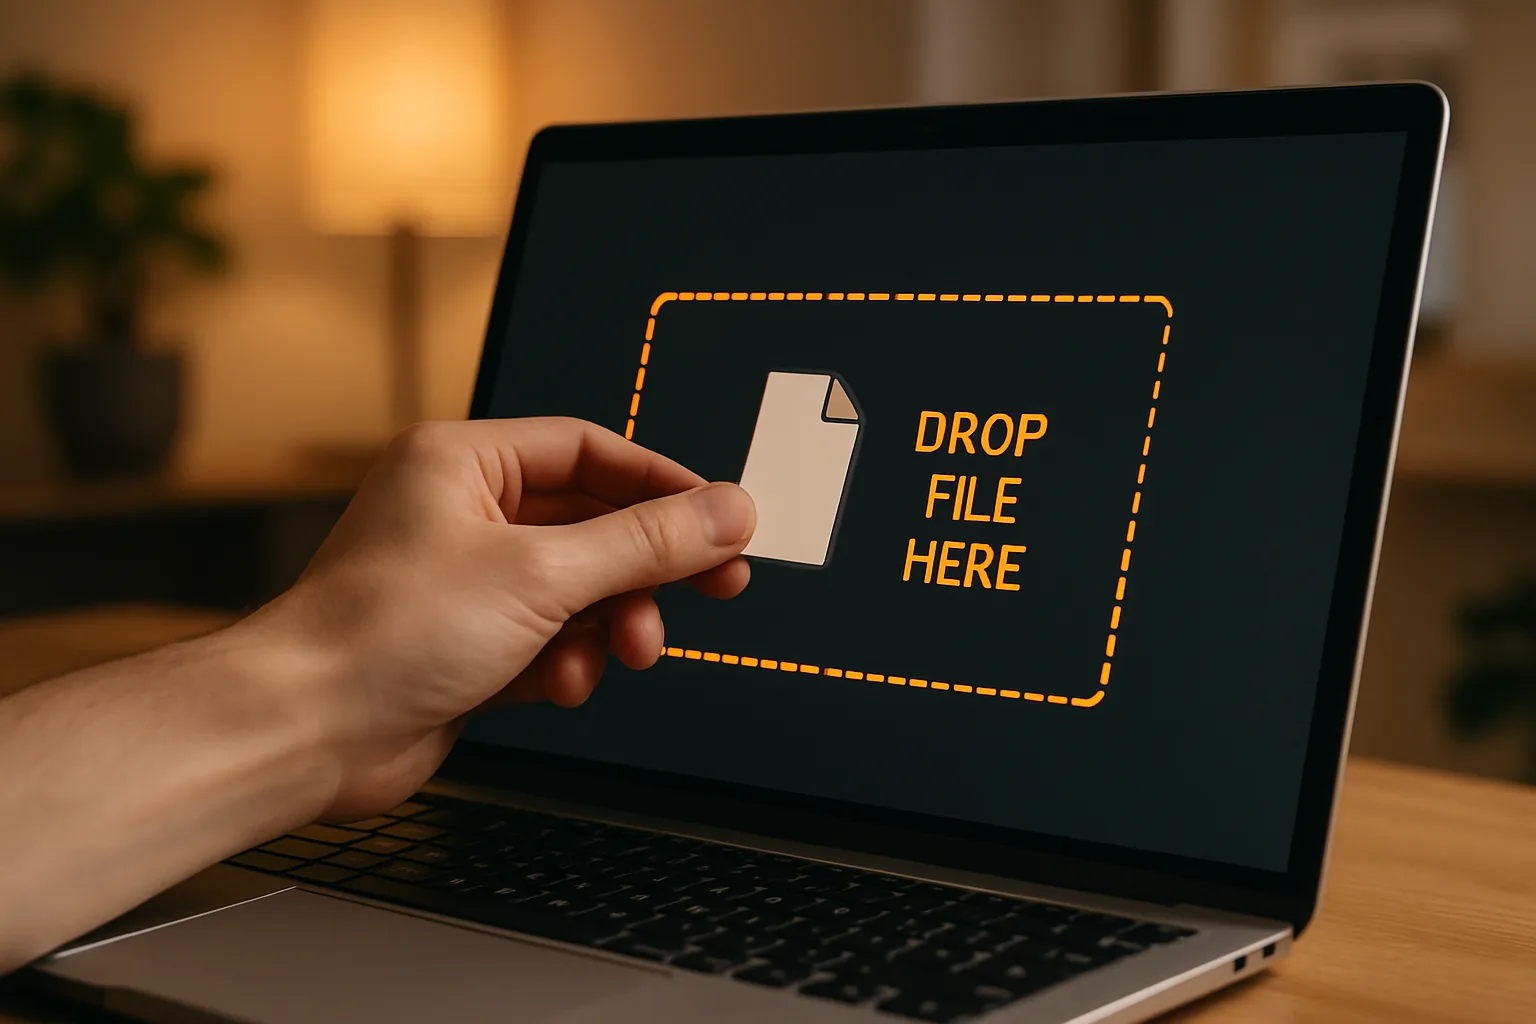
Dépôt Vous faites glisser le document du client sur la page. La zone de dépôt s'illumine avec un contour ambre — la même couleur utilisée dans tout l'importateur pour signaler « attention requise » ou « IA au travail ». La validation côté client s'exécute avant qu'un seul octet n'atteigne le serveur. Elle vérifie l'extension du fichier par rapport à la liste autorisée (PDF, XLSX, XLS, CSV), confirme que le fichier fait moins de 20 Mo, et rejette tout le reste avec un message d'erreur intégré qui nomme le problème — « Les fichiers CSV doivent faire moins de 20 Mo » plutôt que « Fichier invalide ».
La validation côté client n'est pas qu'une question de politesse. Elle évite à l'utilisateur d'attendre 30 secondes un envoi pour recevoir un rejet du serveur. Elle garde aussi les éléments indésirables hors de la file de traitement — aucun binaire corrompu, aucun PDF protégé par mot de passe qui gaspillerait un appel au LLM avant d'échouer. La validation est stricte à la limite et silencieuse en aval : si un fichier franchit la porte, le pipeline suppose qu'il est traitable.
La zone de dépôt accepte également le collage. Si vous avez la feuille de calcul du client ouverte dans un autre onglet, vous pouvez copier les lignes pertinentes et les coller directement. Le gestionnaire de collage détecte les données tabulaires, les normalise au même format interne qu'un envoi de fichier et les achemine vers le même pipeline de traitement. Mêmes étapes, même écran de revue, même résultat. Le mode de saisie ne change pas le comportement — le pipeline ne se soucie pas de la manière dont les octets sont arrivés.
Traitement Une fois le fichier envoyé, une vue de progression plein écran prend le relais. C'est le moment où la plupart des outils d'import perdent l'utilisateur. Un curseur de chargement avec « Traitement... » est honnête mais inutile — il ne donne aucun signal sur le fait que la tâche avance ou est bloquée. Une barre de pourcentage est pire : elle laisse entendre une précision que le système ne possède pas, et une barre figée à 73 % pendant 45 secondes semble en panne alors même que tout va bien.
Quotery utilise une rotation des étapes basée sur le temps plutôt qu'un pourcentage. Six étapes défilent en séquence : « Lecture du document », « Compréhension du contexte », « Détection des groupes », « Correspondance des codes produit », « Déduction des produits par description », « Élaboration de votre devis ». Chaque étape reste visible pendant une durée calée sur le p50 observé des imports réels — environ 3 à 6 secondes par étape selon la taille et la complexité du fichier. Les étapes ne sont pas une progression factice. Elles correspondent à des jalons réels du pipeline : la couche de normalisation lit le document, le LLM raisonne sur la structure, la passe de regroupement identifie les sections, le module de correspondance se confronte aux codes produit, la passe de déduction traite les lignes sans correspondance, et l'assemblage final crée les objets QuoteSection et QuoteLine.
Le rythme est honnête mais non littéral. Un import de 14 lignes peut passer 4 secondes sur « Lecture du document » alors que l'analyse du PDF n'a pris que 1,2 seconde, et 4 secondes sur « Correspondance des codes produit » quand le module déterministe s'est exécuté en 200 ms. Le temps supplémentaire est une réserve — il lisse la variabilité afin que l'utilisateur ne voie jamais une étape défiler en 0,3 seconde suivie d'un blocage de 15 secondes sur la suivante. L'expérience reste cohérente même lorsque le timing sous-jacent est irrégulier.
En coulisses, trois appels au LLM s'exécutent en séquence pendant le traitement. L'appel A normalise le document en JSON structuré : il identifie les sections, regroupe les lignes et extrait le texte brut dont le module de correspondance a besoin. L'appel B effectue la déduction sur les lignes qui n'ont pas pu être mises en correspondance de manière déterministe — il prend une description de produit comme « VENT-450-B 220V INDUSTRIAL » et la rattache au produit connu le plus proche. L'appel C génère la bannière de synthèse (voir l'article 14 pour la justification complète du design). L'utilisateur ne voit jamais ces appels — il voit les étapes défiler et, finalement, le résultat.
Si quelque chose tourne mal pendant le traitement — un PDF protégé par mot de passe, un fichier qui est en réalité une numérisation sans texte extractible, un XLSX corrompu — la vue de progression bascule vers un état d'erreur avec un message précis. « Ce PDF est protégé par mot de passe et ne peut pas être traité » est actionnable. « Échec de l'import » ne l'est pas. Chaque chemin d'erreur du pipeline dispose d'un message lisible qui indique à l'utilisateur ce qui s'est passé et quoi faire ensuite.
Revue La vue de progression se dissout et vous aboutissez sur le nouveau devis. La transition est importante : vous n'atterrissez pas sur une grille de classification brute ni sur un export JSON. Vous arrivez sur la même vue de détail du devis que vous auriez si vous l'aviez construit manuellement — même mise en page, mêmes commandes, mêmes possibilités de modification. La seule différence est que les données sont déjà renseignées et qu'une bannière générée par l'IA, résiliable, se trouve au-dessus du tableau des lignes.
La bannière (abordée en détail dans l'article 14) répond à la seule question que vous vous posez à cet instant : « Que dois-je vérifier ? » Elle dit quelque chose comme « 14 lignes importées. 11 correspondent parfaitement, 2 nécessitent votre revue et 1 n'a pas pu être mise en correspondance — veuillez vérifier la ligne 9. » La bannière est générée par un appel au LLM qui ne reçoit que les comptes de classification et votre locale — aucun nom de produit, aucun prix, aucune donnée client. Elle est limitée à deux phrases au maximum et disparaît dès que vous naviguez.
Chaque ligne du tableau d'éléments porte une pastille de classification. Les pastilles vertes indiquent « Correspondance exacte » — le système a trouvé le produit par code, le prix a été extrait du catalogue produit, et la ligne est prête à l'emploi. Les pastilles ambre indiquent « Décision IA — à revoir » — le module déterministe n'a pas trouvé de correspondance, le LLM a fait sa meilleure estimation, et un humain doit confirmer ou corriger. Les pastilles rouges indiquent « Introuvable » — ni le module de correspondance ni le LLM n'ont pu rattacher cette ligne à un produit connu, et elle nécessite une attention manuelle.
Les couleurs des pastilles créent une hiérarchie visuelle immédiate. Vous pouvez parcourir 14 lignes en moins de 3 secondes et savoir exactement où vous concentrer. Les lignes vertes sont visuellement discrètes — elles sont confirmées, elles sont bonnes, vous n'avez pas à y penser. Les lignes ambre et rouges attirent l'œil. Le design indique « ce sont celles qui ont besoin de vous » sans vous obliger à lire un seul nom de produit.
Toucher une pastille ambre ouvre une comparaison intégrée : la correspondance suggérée par l'IA à gauche, le texte original du client à droite, et une action « Confirmer » ou « Modifier » en dessous. Si l'IA a vu juste — et c'est le cas environ 90 % du temps pour les lignes qu'elle tente — vous touchez Confirmer et la pastille devient verte. Si elle s'est trompée, vous recherchez le produit correct, vous le sélectionnez, et la pastille se met à jour. Les lignes rouges exigent la même recherche manuelle, mais sans suggestion de départ.
L'expérience de revue est l'endroit où l'outil gagne ou perd la confiance. Si l'IA a raison 90 % du temps mais que l'interface de revue fait de la confirmation de ces 90 % une corvée, l'outil a échoué. Si confirmer une estimation correcte de l'IA prend une seule pression et que l'interface ne vous gêne pas, l'outil mérite sa place. Chaque confirmation ambre est une seule pression. Chaque recherche rouge est une consultation à saisie anticipée dans le catalogue produit, limitée à votre tenant, avec correspondance floue sur le nom et le code.
Temps total Un import de 14 lignes avec des résultats de classification typiques — disons 9 vertes, 3 ambre et 2 rouges — prend nettement moins de deux minutes du dépôt à l'envoi. Cela inclut le temps de traitement (environ 25 à 40 secondes selon la complexité du fichier), le temps de revue (confirmer 3 correspondances ambre, rattacher manuellement 2 lignes rouges) et d'éventuels petits ajustements de prix ou de quantité. La même tâche dans une feuille de calcul — saisir 14 codes produit, consulter les prix, calculer les totaux des lignes, mettre en forme le devis — prend de vingt à quarante minutes selon votre familiarité avec le catalogue.
Les gains de temps se cumulent avec le volume. Une équipe qui traite 5 demandes de devis de clients par jour économise environ 90 minutes quotidiennement — l'équivalent d'une journée de travail complète par semaine récupérée sur la saisie de données. Mais les gains les plus importants sont cognitifs. L'importateur prend en charge le travail mécanique de transcription et de mise en correspondance. L'humain assume le travail de jugement de la revue et de l'ajustement. C'est la bonne répartition des tâches entre une machine et une personne qui connaît ses clients.
 DHDTech.io