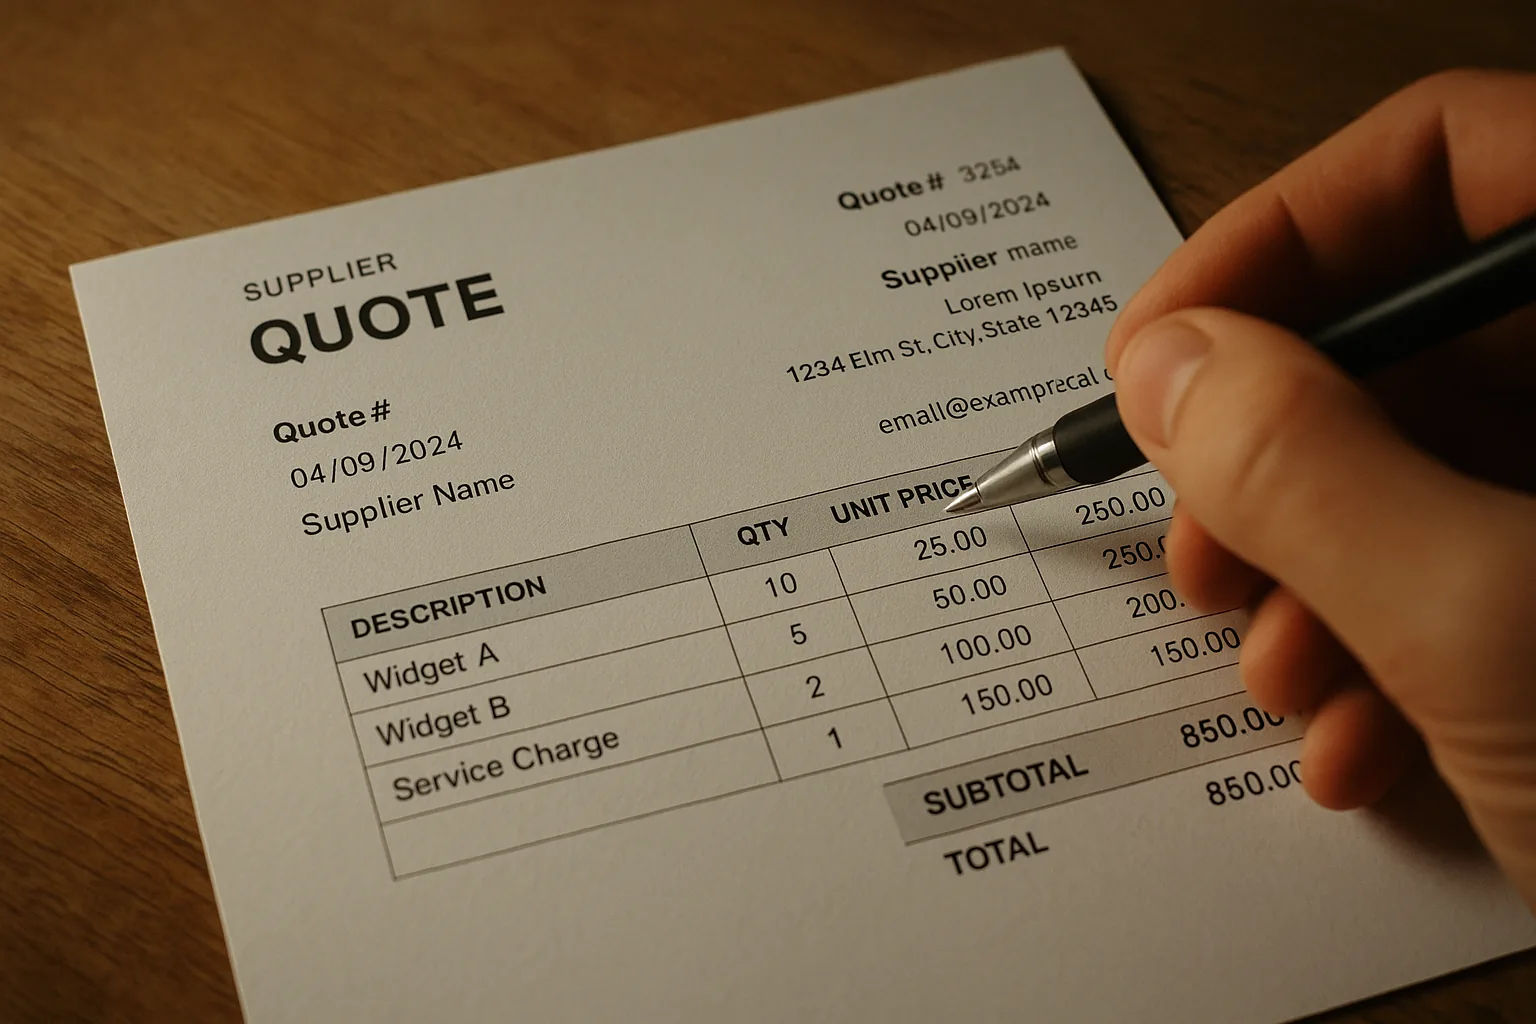
Un PDF client n'a jamais été destiné à être analysé. C'est une page — des colonnes, des zones de texte flottantes, des cellules fusionnées, des notes de bas de page. Écrire un analyseur déterministe pour des PDF clients arbitraires est un puits sans fond de dix ans — c'est pourquoi notre plateforme propulsée par l'IA adopte une approche différente.
Le format PDF en lui-même est l'ennemi. Un PDF ne stocke pas 'un tableau avec 5 colonnes et 12 lignes.' Il stocke des instructions pour dessiner des glyphes à des coordonnées précises sur une page. Deux cellules qui semblent adjacentes dans le rendu peuvent être séparées de plusieurs pages dans le flux de texte interne. Un prix qui apparaît visuellement dans la troisième colonne peut être le premier fragment de texte du fichier. Le PDF a été conçu pour les imprimantes, pas pour les analyseurs — et le pipeline d'export de chaque client produit une variante légèrement différente du chaos.
Le texte d'abord, la structure ensuite
Nous utilisons pypdf pour extraire le texte brut de chaque page, nous le concaténons avec des doubles sauts de ligne, et nous laissons le LLM raisonner sur la structure. Grilles, groupes, unités, colonnes de quantité — le modèle les repère à partir du contexte.
C'est la décision architecturale clé : nous n'essayons pas d'analyser la mise en page interne du PDF. Nous extrayons le texte, nous l'aplatissons, puis nous le confions à un modèle qui comprend la structure du langage naturel. Le modèle voit quelque chose comme 'SKU : AB-001 Composant A 12 pcs 14,50
#x27; et sait — par le contexte et l'entraînement — qu'il s'agit d'une ligne d'article avec un code, une description, une quantité, une unité et un prix. Pas de modèle par client, pas de configuration de correspondance de colonnes, pas d'expression régulière fragile qui casse dès que le client modifie ses paramètres d'export.Le filet de sécurité du schéma JSON
On ne demande jamais de texte libre au modèle. Les sorties structurées du modèle imposent un schéma JSON strict : groupes, articles, codes, quantités, unités, prix. Si le document est uniquement composé d'images (numérisé, sans couche de texte), nous retournons tôt une erreur `unreadable_file` plutôt que de dépenser des jetons.
Le schéma est le contrat. Le modèle ne peut pas renvoyer 'je pense que c'est un article de ligne, mais je n'en suis pas sûr.' Il doit renvoyer un tableau d'objets QuoteSection, chacun contenant des articles QuoteLine avec des champs typés. Si le texte est déformé ou ambigu, le modèle renvoie sa meilleure interprétation — mais toujours selon le schéma. Le code du module d'importation en aval ne se ramifie jamais sur le contenu de la réponse ; il ne valide que la structure. Cette séparation des responsabilités signifie que le pipeline d'importation est testable avec du JSON simulé, et que le prompt de l'IA peut être itéré indépendamment.
Modes de défaillance La plupart des défaillances que nous avons rencontrées proviennent de l'amont — un PDF qui est en réalité une photographie de papier. La solution est hors du champ d'action : nous demandons à l'utilisateur de réexporter depuis le portail de son client. Aucune IA ne peut réparer un document sans texte.
Les PDF uniquement composés d'images sont la cause de défaillance la plus courante, mais pas la seule. Les PDF protégés par mot de passe, les fichiers corrompus qui s'ouvrent dans une visionneuse mais échouent à l'analyse, et les fichiers avec des polices embarquées qui mappent les glyphes vers des points de code Unicode inattendus apparaissent tous en production. Nous les traitons chacun avec un code d'erreur spécifique — unreadable_file, encrypted_file, corrupted_file — afin que le frontend puisse afficher un message exploitable. « Ce fichier est protégé par un mot de passe. Veuillez retirer le mot de passe et réessayer » est plus utile que « Échec du téléversement ».
 DHDTech.io